用 Rust 从头实现机器学习算法·回归⑥:高斯过程回归——核函数与函数的贝叶斯
用 Rust 从头实现机器学习算法·回归⑥:高斯过程回归——核函数与函数的贝叶斯
回归模块的压轴。贝叶斯回归(07 篇)已经对参数给出了后验,但仍预设了”线性”的函数形态——不确定性只来自参数估计。高斯过程(Gaussian Process, GP)更进一步:把函数本身当作随机变量,用核函数直接描述”函数长什么样”,不预设任何全局形式。清单称它”小样本表现极佳”,本篇用 8 个训练点验证这个评价。
核心思想
一个 GP 由均值函数和核函数定义:。任意有限个点上的函数值服从联合高斯,核函数 决定函数的形状与平滑度——它回答”两个输入相距不远时,它们的函数值该有多相关”。选 RBF 核:
是长度尺度:小则函数拐急弯,大则拉成缓坡; 是信号幅度。先验上说,从 GP 采样的函数是”弯弯曲曲但处处光滑”的曲线——这正是对真实物理量测最朴素的建模。
训练即贝叶斯更新:观测 后,任意新点 的预测仍是高斯,均值与方差都有解析解。超参数 不靠人调,用对数边缘似然自动选出——模型自己回答”多弯才算合适”。
数学:核矩阵与后验预测
把 个训练点两两配对算核值,得到核矩阵 (),加观测噪声 。后验预测的均值与方差:
是新点与所有训练点的核值向量。形式与 07 篇的贝叶斯线性回归几乎同构——区别在于那里 是人工设计的特征,这里”特征”由核函数隐式提供,且基函数的个数等于数据点个数。
超参数学习的评分函数(对数边缘似然):
三项各有分工: 惩罚拟合误差,( 的一半)是复杂度惩罚,最后一项是常数。小 拟合好但复杂度罚款重,大 简洁但拟合差——LML 替我们走这条钢丝。
实现上有一个关键工程决定:不显式求逆。解 和算 都用 Cholesky 分解 :回代求解快且数值稳定,。这也是 06 篇手写的高斯-约当求逆在本篇”退役”的原因。
Rust 实现
// src/main.rs(段一:Matrix 含 Cholesky、GpReg/GpPosterior 与主程序)
// 回归⑥:高斯过程回归——用核函数对函数建模
// 单文件、仅标准库。绘图器与 01~07 篇内联的是同一份实现。

// ===================== Matrix(含 Cholesky 分解,本篇新增) =====================

#[derive(Debug, Clone)]
struct Matrix {
    data: Vec<f64>,
    rows: usize,
    cols: usize,
}

impl Matrix {
    fn from_vec(data: Vec<f64>, rows: usize, cols: usize) -> Matrix {
        assert_eq!(data.len(), rows * cols, "数据长度与矩阵形状不一致");
        Matrix { data, rows, cols }
    }

    fn zeros(rows: usize, cols: usize) -> Matrix {
        Matrix { data: vec![0.0; rows * cols], rows, cols }
    }

    fn shape(&self) -> (usize, usize) {
        (self.rows, self.cols)
    }

    fn get(&self, i: usize, j: usize) -> f64 {
        self.data[i * self.cols + j]
    }

    fn matmul(&self, other: &Matrix) -> Matrix {
        assert_eq!(self.cols, other.rows, "内维不一致:{:?} 无法乘 {:?}", self.shape(), other.shape());
        let mut out = Matrix::zeros(self.rows, other.cols);
        for i in 0..self.rows {
            for j in 0..other.cols {
                let mut sum = 0.0;
                for k in 0..self.cols {
                    sum += self.get(i, k) * other.get(k, j);
                }
                out.data[i * out.cols + j] = sum;
            }
        }
        out
    }

    fn transpose(&self) -> Matrix {
        let mut out = Matrix::zeros(self.cols, self.rows);
        for i in 0..self.rows {
            for j in 0..self.cols {
                out.data[j * self.rows + i] = self.get(i, j);
            }
        }
        out
    }

    /// Cholesky 分解:K = L·Lᵀ(L 为下三角)。K 非正定返回 None。
    /// 实际的高斯过程实现几乎总是用 Cholesky 而不是显式求逆:更快、更稳。
    fn cholesky(&self) -> Option<Matrix> {
        assert_eq!(self.rows, self.cols, "Cholesky 只对方阵定义");
        let n = self.rows;
        let mut l = Matrix::zeros(n, n);
        for i in 0..n {
            for j in 0..=i {
                let mut s = self.get(i, j);
                for p in 0..j {
                    s -= l.get(i, p) * l.get(j, p);
                }
                if i == j {
                    if s <= 1e-10 {
                        return None; // 非正定(数值上)
                    }
                    l.data[i * n + i] = s.sqrt();
                } else {
                    l.data[i * n + j] = s / l.get(j, j);
                }
            }
        }
        Some(l)
    }

    /// 用 Cholesky 因子 L 解 K·x = b(先解 L,再解 Lᵀ)。
    fn cho_solve(&self, b: &Matrix) -> Matrix {
        let n = self.rows;
        let cols = b.cols;
        let mut z = Matrix::zeros(n, cols);
        for i in 0..n {
            for c in 0..cols {
                let mut s = b.get(i, c);
                for p in 0..i {
                    s -= self.get(i, p) * z.get(p, c);
                }
                z.data[i * cols + c] = s / self.get(i, i);
            }
        }
        let mut x = Matrix::zeros(n, cols);
        for i in (0..n).rev() {
            for c in 0..cols {
                let mut s = z.get(i, c);
                for p in i + 1..n {
                    s -= self.get(p, i) * x.get(p, c);
                }
                x.data[i * cols + c] = s / self.get(i, i);
            }
        }
        x
    }

    /// 对数行列式:ln|K| = 2·Σ ln(L_ii)(借 Cholesky 因子)。
    fn logdet_from_cho(l: &Matrix) -> f64 {
        (0..l.rows).map(|i| l.get(i, i).ln()).sum::<f64>() * 2.0
    }
}

// ===================== xorshift64 + Box-Muller 正态采样(沿用 07 篇) =====================

struct XorShift(u64);

impl XorShift {
    fn new(seed: u64) -> Self {
        assert!(seed != 0, "种子不能为 0");
        XorShift(seed)
    }

    fn next_u64(&mut self) -> u64 {
        let mut x = self.0;
        x ^= x << 13;
        x ^= x >> 7;
        x ^= x << 17;
        self.0 = x;
        x
    }

    fn next_f64(&mut self) -> f64 {
        (self.next_u64() >> 11) as f64 / (1u64 << 53) as f64
    }

    fn next_gauss(&mut self) -> f64 {
        let u1 = 1.0 - self.next_f64();
        let u2 = self.next_f64();
        (-2.0 * u1.ln()).sqrt() * (2.0 * std::f64::consts::PI * u2).cos()
    }
}

// ===================== 高斯过程回归(零均值 GP + RBF 核) =====================

/// RBF 核 k(x, x') = σf² · exp(−(x−x')² / (2ℓ²))。
/// ℓ(长度尺度)决定函数拐多急的弯,σf 决定函数摆多大幅度。
struct GpReg {
    length: f64, // ℓ
    signal: f64, // σf
    noise: f64,  // σn(观测噪声标准差)
}

/// 训练后的后验对象:保存 Cholesky 因子与 α = K⁻¹y,预测时 O(n²)。
struct GpPosterior {
    train_x: Vec<f64>,
    l: Matrix,
    alpha: Matrix,
    signal2: f64,
    noise2: f64,
    length2: f64,
}

impl GpReg {
    fn kernel(&self, a: f64, b: f64) -> f64 {
        self.signal.powi(2) * (-(a - b).powi(2) / (2.0 * self.length.powi(2))).exp()
    }

    /// 核矩阵(加噪声项与抖动保证正定)。
    fn kernel_matrix(&self, xs: &[f64]) -> Matrix {
        let n = xs.len();
        let mut k = Matrix::zeros(n, n);
        for i in 0..n {
            for j in 0..n {
                k.data[i * n + j] = self.kernel(xs[i], xs[j]);
            }
            k.data[i * n + i] += self.noise.powi(2) + 1e-8;
        }
        k
    }

    /// 拟合:解一次 K α = y。
    fn fit(&self, xs: &[f64], ys: &[f64]) -> Option<GpPosterior> {
        let k = self.kernel_matrix(xs);
        let l = k.cholesky()?;
        let alpha = l.cho_solve(&Matrix::from_vec(ys.to_vec(), xs.len(), 1));
        Some(GpPosterior {
            train_x: xs.to_vec(),
            l,
            alpha,
            signal2: self.signal.powi(2),
            noise2: self.noise.powi(2),
            length2: self.length.powi(2),
        })
    }

    /// 对数边缘似然(超参数选择的评分函数):
    /// log p(y) = −½ yᵀα − Σ ln L_ii − (n/2) ln 2π
    fn log_marginal_likelihood(&self, xs: &[f64], ys: &[f64]) -> Option<f64> {
        let n = xs.len();
        let k = self.kernel_matrix(xs);
        let l = k.cholesky()?;
        let alpha = l.cho_solve(&Matrix::from_vec(ys.to_vec(), n, 1));
        let y = Matrix::from_vec(ys.to_vec(), n, 1);
        let quad = y.transpose().matmul(&alpha).data[0];
        let logdet = Matrix::logdet_from_cho(&l);
        Some(-0.5 * quad - 0.5 * logdet - 0.5 * n as f64 * (2.0 * std::f64::consts::PI).ln())
    }
}

impl GpPosterior {
    /// 后验预测:均值 k*ᵀα,方差 σf² + σn² − vᵀv(v = L⁻¹k*)。
    fn predict(&self, x: f64) -> (f64, f64) {
        let n = self.train_x.len();
        let mut ks = vec![0.0; n];
        for (i, tx) in self.train_x.iter().enumerate() {
            ks[i] = self.signal2 * (-(x - tx).powi(2) / (2.0 * self.length2)).exp();
        }
        let ks_mat = Matrix::from_vec(ks.clone(), n, 1);
        let mean = ks_mat.transpose().matmul(&self.alpha).data[0];
        let v = self.l.cho_solve(&ks_mat);
        let var = (self.signal2 + self.noise2 - v.transpose().matmul(&v).data[0]).max(0.0);
        (mean, var)
    }
}

fn truth(x: f64) -> f64 {
    0.15 * x * x * x - x * x + 2.0 * x + 3.0
}

fn mse(yhats: &[f64], ys: &[f64]) -> f64 {
    let n = ys.len();
    let se: f64 = yhats.iter().zip(ys.iter()).map(|(a, b)| (a - b).powi(2)).sum();
    se / n as f64
}

fn main() {
    let out_dir = "../../../frontend/public/images/series/rust-ml-08-gpr";
    std::fs::create_dir_all(out_dir).expect("创建输出目录失败");

    // ---- 1. 数据:沿用 05/06 的三次曲线真值,只给 8 个训练点(小样本主场) ----
    let mut rng = XorShift::new(42);
    let n = 8usize;
    let mut xs = Vec::with_capacity(n);
    let mut ys = Vec::with_capacity(n);
    for _ in 0..n {
        let x = rng.next_f64() * 5.0;
        xs.push(x);
        ys.push(truth(x) + 0.1 * rng.next_gauss());
    }
    println!("训练点:{n} 个,真值 y = 0.15x³ − x² + 2x + 3,噪声 σ = 0.1");

    // ---- 2. 超参数网格搜索:最大化对数边缘似然 ----
    let lengths = [0.3, 0.5, 1.0, 2.0, 3.0];
    let signals = [0.5, 1.0, 2.0];
    let noises = [0.05, 0.1, 0.2];
    let mut best: Option<(f64, GpReg)> = None;
    for &l in &lengths {
        for &sf in &signals {
            for &sn in &noises {
                let gp = GpReg { length: l, signal: sf, noise: sn };
                if let Some(lml) = gp.log_marginal_likelihood(&xs, &ys) {
                    let better = match best {
                        Some((score, _)) => lml > score,
                        None => true,
                    };
                    if better {
                        best = Some((lml, gp));
                    }
                }
            }
        }
    }
    let (best_lml, best_gp) = best.expect("网格非空,必有最优");
    println!(
        "网格搜索最优:ℓ = {:.1},σf = {:.1},σn = {:.2}(log p(y) = {:.3})",
        best_gp.length, best_gp.signal, best_gp.noise, best_lml
    );

    println!("\n[固定 σf={:.1}, σn={:.2}] ℓ 扫描:", best_gp.signal, best_gp.noise);
    for &l in &lengths {
        let gp = GpReg { length: l, signal: best_gp.signal, noise: best_gp.noise };
        let lml = gp.log_marginal_likelihood(&xs, &ys).unwrap();
        println!("  ℓ = {:.1}   log p(y) = {:+.4}   {}", l, lml, if l == best_gp.length { "← 最优" } else { "" });
    }

    // ---- 3. 后验预测与置信带 ----
    let post = best_gp.fit(&xs, &ys).expect("带噪声的核矩阵必正定");
    let grid: Vec<f64> = (0..=120).map(|k| k as f64 * 0.05 - 1.0).collect(); // x ∈ [-1, 5]
    let mut mean_c = Vec::new();
    let mut upper_c = Vec::new();
    let mut lower_c = Vec::new();
    for &x in &grid {
        let (m, v) = post.predict(x);
        let s = v.sqrt();
        mean_c.push((x, m));
        upper_c.push((x, m + 2.0 * s));
        lower_c.push((x, m - 2.0 * s));
    }
    let mse_train = mse(&(0..n).map(|i| post.predict(xs[i]).0).collect::<Vec<_>>(), &ys);
    let (_, v25) = post.predict(2.5);
    println!("\n训练集 MSE = {:.6}(噪声地板 σ² = 0.01)", mse_train);
    println!("x = 2.5 处 ±2σ 带宽 = {:.3}", 4.0 * v25.sqrt());

    let mut c = Canvas::new(560.0, 380.0, -1.0, 5.0, -1.0, 9.0);
    c.axes("x", "y");
    c.band(&upper_c, &lower_c, PALETTE[0]);
    c.polyline(&mean_c, PALETTE[0], 2.2);
    c.dots(&xs.iter().copied().zip(ys.iter().copied()).collect::<Vec<_>>(), "#16161d", 4.0);
    c.legend(&[("GP 后验均值", PALETTE[0]), ("±2σ 带", PALETTE[0]), ("train", "#16161d")]);
    let p1 = format!("{out_dir}/gp-fit.svg");
    c.save(&p1);

    // ---- 4. 长度尺度的作用:ℓ 小扭得快,ℓ 大拉得平 ----
    let mut c = Canvas::new(560.0, 380.0, -1.0, 5.0, -1.0, 9.0);
    c.axes("x", "y");
    c.dots(&xs.iter().copied().zip(ys.iter().copied()).collect::<Vec<_>>(), "#16161d", 3.5);
    let mut labels = vec!["train".to_string()];
    let mut colors: Vec<&str> = vec!["#16161d"];
    for (i, &l) in [0.3f64, 1.0, 3.0].iter().enumerate() {
        let gp = GpReg { length: l, signal: best_gp.signal, noise: best_gp.noise };
        let post = gp.fit(&xs, &ys).unwrap();
        let curve: Vec<(f64, f64)> = grid.iter().map(|&x| (x, post.predict(x).0)).collect();
        c.polyline(&curve, PALETTE[i], 2.0);
        labels.push(format!("ℓ = {l}"));
        colors.push(PALETTE[i]);
    }
    let entries: Vec<(&str, &str)> = labels.iter().zip(colors.iter()).map(|(l, c)| (l.as_str(), *c)).collect();
    c.legend(&entries);
    let p2 = format!("{out_dir}/lengthscale.svg");
    c.save(&p2);

    println!("图已写入:{p1}、{p2}");
}

// ===================== 迷你 SVG 绘图器(与系列前篇一致) =====================

(与系列前篇一致) =====================

/// 系列默认配色:朱橙 / 青绿 / 蓝 / 琥珀(取自站点设计令牌)。
const PALETTE: [&str; 4] = ["#d6491f", "#0f766e", "#2563eb", "#d97706"];

struct Canvas {
    w: f64,
    h: f64,
    xmin: f64,
    xmax: f64,
    ymin: f64,
    ymax: f64,
    pad_l: f64,
    pad_r: f64,
    pad_t: f64,
    pad_b: f64,
    body: String,
}

impl Canvas {
    fn new(w: f64, h: f64, xmin: f64, xmax: f64, ymin: f64, ymax: f64) -> Canvas {
        let (xmin, xmax) = spread(xmin, xmax);
        let (ymin, ymax) = spread(ymin, ymax);
        Canvas {
            w,
            h,
            xmin,
            xmax,
            ymin,
            ymax,
            pad_l: 52.0,
            pad_r: 16.0,
            pad_t: 16.0,
            pad_b: 40.0,
            body: String::new(),
        }
    }

    fn px(&self, x: f64) -> f64 {
        self.pad_l + (x - self.xmin) / (self.xmax - self.xmin) * (self.w - self.pad_l - self.pad_r)
    }

    fn py(&self, y: f64) -> f64 {
        self.h - self.pad_b - (y - self.ymin) / (self.ymax - self.ymin) * (self.h - self.pad_t - self.pad_b)
    }

    fn polyline(&mut self, pts: &[(f64, f64)], color: &str, width: f64) {
        let mut d = String::new();
        for (i, (x, y)) in pts.iter().enumerate() {
            let _ = write!(d, "{}{:.1},{:.1}", if i == 0 { "M" } else { "L" }, self.px(*x), self.py(*y));
        }
        let _ = write!(
            self.body,
            r##"<path d="{d}" fill="none" stroke="{color}" stroke-width="{width}" stroke-linejoin="round"/>"##
        );
    }

    fn dots(&mut self, pts: &[(f64, f64)], color: &str, r: f64) {
        for (x, y) in pts {
            let _ = write!(
                self.body,
                r##"<circle cx="{:.1}" cy="{:.1}" r="{r}" fill="{color}" fill-opacity="0.65"/>"##,
                self.px(*x),
                self.py(*y)
            );
        }
    }

    /// 置信带:upper/lower 两条曲线围成的区域,半透明填充。
    fn band(&mut self, upper: &[(f64, f64)], lower: &[(f64, f64)], color: &str) {
        let mut d = String::new();
        for (i, (x, y)) in upper.iter().enumerate() {
            let _ = write!(d, "{}{:.1},{:.1}", if i == 0 { "M" } else { "L" }, self.px(*x), self.py(*y));
        }
        for (x, y) in lower.iter().rev() {
            let _ = write!(d, "L{:.1},{:.1}", self.px(*x), self.py(*y));
        }
        let _ = write!(
            self.body,
            r##"<path d="{d}Z" fill="{color}" fill-opacity="0.15" stroke="none"/>"##
        );
    }

    fn axes(&mut self, xlabel: &str, ylabel: &str) {
        let x0 = self.px(self.xmin);
        let x1 = self.px(self.xmax);
        let y0 = self.py(self.ymin);
        let y1 = self.py(self.ymax);
        for t in nice_ticks(self.xmin, self.xmax, 6) {
            let x = self.px(t);
            let _ = write!(
                self.body,
                r##"<line x1="{x:.1}" y1="{y0:.1}" x2="{x:.1}" y2="{y1:.1}" stroke="#16161d" stroke-opacity="0.08"/>"##
            );
            let _ = write!(
                self.body,
                r##"<text x="{x:.1}" y="{:.1}" text-anchor="middle" fill="#16161d" fill-opacity="0.45">{t:.6}</text>"##,
                y0 + 16.0,
                t = trim(t)
            );
        }
        for t in nice_ticks(self.ymin, self.ymax, 6) {
            let y = self.py(t);
            let _ = write!(
                self.body,
                r##"<line x1="{x0:.1}" y1="{y:.1}" x2="{x1:.1}" y2="{y:.1}" stroke="#16161d" stroke-opacity="0.08"/>"##
            );
            let _ = write!(
                self.body,
                r##"<text x="{:.1}" y="{:.1}" text-anchor="end" fill="#16161d" fill-opacity="0.45">{t:.6}</text>"##,
                x0 - 6.0,
                y + 4.0,
                t = trim(t)
            );
        }
        let _ = write!(
            self.body,
            r##"<path d="M{x0:.1},{y0:.1}H{x1:.1}M{x0:.1},{y0:.1}V{y1:.1}" fill="none" stroke="#16161d" stroke-opacity="0.6"/>"##
        );
        let _ = write!(
            self.body,
            r##"<text x="{:.1}" y="{:.1}" text-anchor="middle" fill="#16161d" fill-opacity="0.7">{xlabel}</text>"##,
            (x0 + x1) / 2.0,
            self.h - 8.0
        );
        let _ = write!(
            self.body,
            r##"<text x="14" y="{:.1}" text-anchor="middle" transform="rotate(-90 14 {:.1})" fill="#16161d" fill-opacity="0.7">{ylabel}</text>"##,
            (y0 + y1) / 2.0,
            (y0 + y1) / 2.0
        );
    }

    /// 图例:右上角依次画「色线 + 文字」。
    fn legend(&mut self, entries: &[(&str, &str)]) {
        let sample_w = 22.0;
        let line_h = 18.0;
        let x0 = self.w - self.pad_r - 78.0;
        let x_text = x0 + sample_w + 6.0;
        for (i, (label, color)) in entries.iter().enumerate() {
            let y = self.pad_t + 14.0 + i as f64 * line_h;
            let _ = write!(
                self.body,
                r##"<line x1="{x0:.1}" y1="{y:.1}" x2="{:.1}" y2="{y:.1}" stroke="{color}" stroke-width="2.5"/>"##,
                x0 + sample_w
            );
            let _ = write!(
                self.body,
                r##"<text x="{x_text:.1}" y="{:.1}" fill="#16161d" fill-opacity="0.7">{label}</text>"##,
                y + 4.0
            );
        }
    }

    fn save(&self, path: &str) {
        let svg = format!(
            r##"<svg xmlns="http://www.w3.org/2000/svg" viewBox="0 0 {w} {h}" font-family="'JetBrains Mono',monospace" font-size="11"><rect width="{w}" height="{h}" fill="#fbfaf7"/>{body}</svg>"##,
            w = self.w,
            h = self.h,
            body = self.body
        );
        std::fs::write(path, svg).expect("写 SVG 失败");
    }
}

fn trim(v: f64) -> String {
    let s = format!("{v:.6}");
    s.trim_end_matches('0').trim_end_matches('.').to_string()
}

fn spread(min: f64, max: f64) -> (f64, f64) {
    if min == max {
        (min - 1.0, max + 1.0)
    } else {
        let pad = (max - min) * 0.05;
        (min - pad, max + pad)
    }
}

fn nice_ticks(min: f64, max: f64, n: usize) -> Vec<f64> {
    let raw = (max - min) / n.max(1) as f64;
    if raw <= 0.0 || !raw.is_finite() {
        return vec![min];
    }
    let exp = raw.abs().log10().floor() as i32;
    let base = 10f64.powi(exp);
    let frac = raw / base;
    let step = if frac <= 1.0 {
        base
    } else if frac <= 2.0 {
        2.0 * base
    } else if frac <= 2.5 {
        2.5 * base
    } else if frac <= 5.0 {
        5.0 * base
    } else {
        10.0 * base
    };
    let mut ticks = Vec::new();
    let mut t = (min / step).ceil() * step;
    while t <= max + 1e-9 {
        ticks.push(if t.abs() < step * 1e-9 { 0.0 } else { t });
        t += step;
    }
    ticks
}
实现要点:
cholesky只访问下三角, 判非正定返回None——抖动项 保证带噪声的核矩阵几乎必然正定。cho_solve一次前代 + 一次回代解出 ;predict里先解 再算 ,全程没有逆矩阵。fit的产出是GpPosterior结构体:训练的全部信息(Cholesky 因子 + )打包带走,预测阶段只做 矩阵乘法——增量学习、在线更新都从这里长出来。- 超参数搜索是三重循环 + 打擂台(
better标志),网格只有 ——GP 的痛点 在 时毫无存在感。
// src/main.rs 段二:迷你 SVG 绘图器(与系列前篇同一份实现)
use std::fmt::Write as _;
// src/main.rs 末尾:单元测试(cargo test 运行)
#[cfg(test)]
mod tests {
    use super::*;

    #[test]
    fn kernel_is_symmetric_and_max_on_diagonal() {
        let gp = GpReg { length: 1.0, signal: 2.0, noise: 0.1 };
        assert_eq!(gp.kernel(1.0, 3.0), gp.kernel(3.0, 1.0));
        assert!((gp.kernel(2.0, 2.0) - 4.0).abs() < 1e-12); // k(x,x) = σf²
        assert!(gp.kernel(0.0, 5.0) < 1e-4); // 远处几乎无关(对角线为 4)
    }

    #[test]
    fn cholesky_reconstructs_matrix() {
        let gp = GpReg { length: 1.0, signal: 1.0, noise: 0.1 };
        let xs: Vec<f64> = vec![0.5, 1.5, 2.5, 3.5];
        let k = gp.kernel_matrix(&xs);
        let l = k.cholesky().expect("带噪声核矩阵必正定");
        let prod = l.matmul(&l.transpose());
        for i in 0..4 {
            for j in 0..4 {
                assert!((prod.get(i, j) - k.get(i, j)).abs() < 1e-8);
            }
        }
    }

    #[test]
    fn cholesky_rejects_indefinite() {
        let bad = Matrix::from_vec(vec![1.0, 2.0, 2.0, 1.0], 2, 2); // 不定矩阵
        assert!(bad.cholesky().is_none());
    }

    #[test]
    fn posterior_interpolates_with_tiny_noise() {
        let mut rng = XorShift::new(9);
        let xs: Vec<f64> = (0..6).map(|i| i as f64).collect();
        let ys: Vec<f64> = xs.iter().map(|&x| truth(x) + 0.001 * rng.next_gauss()).collect();
        let gp = GpReg { length: 1.0, signal: 1.5, noise: 0.01 };
        let post = gp.fit(&xs, &ys).unwrap();
        for i in 0..6 {
            let (m, _) = post.predict(xs[i]);
            assert!((m - ys[i]).abs() < 0.05, "应插值回训练点:{m} vs {}", ys[i]);
        }
    }
}
Rust 语法角:模式匹配进阶——元组解构与下划线
本篇的 let (m, v) = post.predict(x) 是元组解构:函数返回 (f64, f64),一个 let 就把两个分量同时命名。打擂台处的 match best { Some((score, _)) => lml > score, None => true } 则集三种手法于一身:对 Option 分层匹配、把 Some 里的元组再拆开、用下划线 _ 声明”这个分量我不关心”。Python 的对应写法是元组解包与 if best is None,但要自己保证结构正确;Rust 的模式在编译期检查”拆出来的形状必须匹配”。详见《Rust 程序设计语言》ch18(模式与模式匹配)。
运行结果
cargo test(4 个用例:核的对称性与对角线、Cholesky 重构 、不定矩阵拒解、近零噪声时后验插值回训练点)全部通过后,cargo run:
训练点:8 个,真值 y = 0.15x³ − x² + 2x + 3,噪声 σ = 0.1
网格搜索最优:ℓ = 2.0,σf = 2.0,σn = 0.10(log p(y) = -3.912)

[固定 σf=2.0, σn=0.10] ℓ 扫描:
  ℓ = 0.3   log p(y) = -18.6740
  ℓ = 0.5   log p(y) = -13.6767
  ℓ = 1.0   log p(y) = -7.6321
  ℓ = 2.0   log p(y) = -3.9120   ← 最优
  ℓ = 3.0   log p(y) = -4.7690

训练集 MSE = 0.004429(噪声地板 σ² = 0.01)
x = 2.5 处 ±2σ 带宽 = 7.629
图已写入:../../../frontend/public/images/series/rust-ml-08-gpr/gp-fit.svg、../../../frontend/public/images/series/rust-ml-08-gpr/lengthscale.svg
两张图:
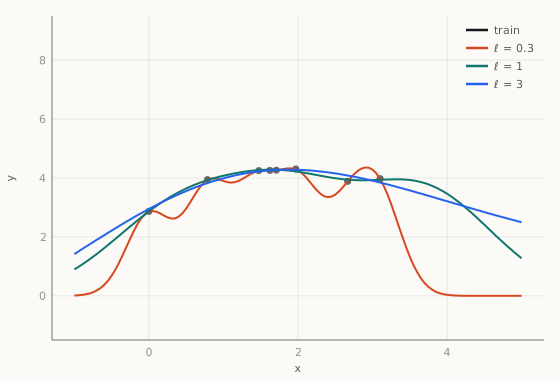
怎么读这些数字和图
- ℓ 扫描是复杂度的天平:ℓ=0.3 时 log p(y) = −18.7——曲线扭来扭去穿过了每个噪声点,拟合项赢了、复杂度罚款输了;ℓ=2.0 时 −3.9 登顶;ℓ=3 又滑到 −4.8——太平滑漏掉了真值的弯。LML 不依赖验证集就完成了模型选择,这是贝叶斯框架的体制性优势。
- 8 个点、MSE 0.0044、低于噪声地板 0.01:均值曲线几乎插值穿过全部训练点。注意这不矛盾——带噪声的 GP 预测的是”观测值”(含 σn²),训练点上观测值就是 y。
- ±2σ 带宽 7.6 提醒我们它有多诚实:8 个点撑不起一条唯一的三次曲线,后验方差大是事实陈述而非模型缺陷。想要更窄的带,要么加数据,要么更强的先验——不确定性不会凭空消失,只会被转移。
- lengthscale.svg 是核函数的视觉词典:同一份数据,ℓ=0.3 的均值在每个点附近剧烈扭动(过拟合的先验必然),ℓ=3 几乎拉成直线(欠拟合),ℓ=2 平滑地追踪真值的起伏。核函数的选择与超参,就是 GP 世界里”模型假设”的全部内容。
优缺点与适用场景
(抄清单 1.10 原文)
- 优点:小样本表现极佳、输出带置信区间、核函数灵活可定制(可注入领域知识)。
- 缺点:计算复杂度 O(n³),大数据集不可用;理解门槛高。
- 适用场景:样本少但标注贵的场景(超参数搜索、A/B 测试、实验设计)、时序预测。
小结
至此回归模块收官。六篇走完一条路:最小二乘(03)→ 特征缩放与 L2(04)→ 复杂度与过拟合(05)→ 正则化三兄弟(06)→ 参数的后验(07)→ 函数的后验(08)。工具始终是那个 Matrix,世界观换了好几轮。下一模块进入分类:09 逻辑回归与交叉熵——sigmoid 把线性输出变成概率,损失函数从平方误差换成对数损失。