用 Rust 从头实现机器学习算法·基础篇(上):开发环境与 Matrix
用 Rust 从头实现机器学习算法·基础篇(上):开发环境与 Matrix
这个系列想做一件朴素的事:不调用任何现成的机器学习库,只用 Rust 标准库,把常见的机器学习算法从头写一遍——从矩阵运算开始,到回归、分类、聚类、降维,再到集成学习。每一行数学公式,都对应一段你能读懂、能修改、能运行的 Rust 代码。目标读者是有编程基础、数学只需高中水平的朋友:我们重直觉、重实现,每个概念都配完整可编译的代码和真实的运行输出。
核心思想
为什么用 Rust 学机器学习
性能:算法应该跑得动真实数据。 学习阶段的数据量往往很小,“快不快”似乎无所谓。但”算法能在真实规模的数据上跑起来”和”算法只能在玩具数据上爬”是两种完全不同的学习体验。Rust 编译为本地机器码,没有垃圾回收,数值密集型循环的性能与 C 相当——同一份学习代码,将来稍加打磨就能进入生产环境。
类型系统:让错误死在编译期。 在动态类型语言里写矩阵运算,最容易犯的错是维度不匹配:把一个 的向量加到一个 的矩阵上。这类错误往往要等到程序运行到那一行才抛异常;如果那行位于一个不常触发的分支,bug 可能潜伏很久。Rust 的哲学是:能在编译期抓住的错误,绝不拖到运行期。本系列先用断言让维度错误在边界处第一时间 panic(fail fast);到系列后期,我们会用泛型把行列数直接编码进类型,让”两个矩阵能不能相乘”由编译器在编译期裁决。
零成本抽象。 迭代器、泛型、trait……Rust 的高层抽象经单态化等优化后,性能与手写代码一致。机器学习代码的本质是”对数据里的每个元素批量做同一件事”,这些抽象恰好贴合数据运算的表达习惯,又不产生运行时开销。
和 Python 是什么关系
先说明:本系列不贬低 Python。今天机器学习的科研生态——PyTorch、Jupyter、NumPy——几乎都在 Python 之上;做研究、快速验证想法,Python 依然是最顺手的工具。二者的关系是互补而非替代:Python 适合探索,Rust 适合把探索出的成果做成可靠、高性能的产品。而在”理解原理”这件事上,语言只是载体,关键是亲手写下每一个步骤。选择 Rust,恰恰因为它对犯错最不宽容:它强迫你时刻想清楚每个数据的形状与所有权——这种纪律正是理解算法的捷径。
环境搭建
安装 Rust 最简单的方式是官方版本管理工具 rustup。Linux 或 macOS 打开终端执行:
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | shWindows 用户从官网下载 rustup-init.exe。安装后验证:
rustc --version   # 编译器
cargo --version # 构建与包管理工具,日常几乎只和它打交道常用命令只有三个:cargo build 编译,cargo test 运行测试,cargo run 编译并运行。本篇的完整代码在仓库的 series/rust-ml-01-intro/ 目录下,进去执行 cargo test 或 cargo run 即可复现本文全部输出。
体例说明:为什么改成单文件
旧版基础篇把代码拆成 lib.rs(算法库)和 main.rs(演示入口)。v2 系列统一改为单文件 main.rs:文章里的每一段代码按顺序拼进同一个文件,就得到可直接编译运行的完整程序——单元测试和业务代码同文件并存(Rust 原生支持),cargo test、cargo run 一条命令搞定,读者无需操心模块组织,专注算法本身。
数学:两个即将写进代码的公式
本篇的”推导”很轻,就是要写进代码的两个定义。
行优先存储的索引公式。 一个 的矩阵,全部元素存放在一块连续内存(Vec<f64>)里,第 行第 列的元素下标为
这叫做行优先(row-major)布局:一行写完再写下一行。为什么不用 Vec<Vec<f64>>?因为外层向量的每行在堆上单独分配、内存不连续,遍历时缓存命中率低;单一 Vec 则紧凑且缓存友好。
带噪声的数据模型。 主程序要造一批模拟数据再画散点图,模型是
均匀取自 ; 是均匀噪声,代表观测误差。这就是机器学习的原题:从带噪声的观测里恢复背后的规律(这里是正弦曲线)。最后还要验证统计量是否符合理论,用到样本均值与样本标准差:
理论上 ,而方差可以分解为两部分:。程序算出来的 和 应当分别落在 和 附近——具体偏多少,正是”抽 120 个样本”的随机性,后面看图时细说。
Rust 实现
以下五段代码按顺序拼进同一个 src/main.rs,即仓库中的完整程序。全程仅依赖 Rust 标准库,rustc 1.75 即可编译,无任何外部 crate。
第一段:Matrix
矩阵是整个系列唯一的核心数据结构:数据集是矩阵(一行一个样本),权重是矩阵,预测结果也是矩阵。
// src/main.rs(第一段:Matrix)
/// 行优先存储的二维浮点矩阵。
#[derive(Debug, Clone, PartialEq)]
struct Matrix {
    data: Vec<f64>, // 第 i 行第 j 列的元素存放在 data[i * cols + j]
    rows: usize,
    cols: usize,
}

impl Matrix {
    /// 构造一个所有元素都等于 fill 的 rows×cols 矩阵。
    fn new(rows: usize, cols: usize, fill: f64) -> Self {
        assert!(rows > 0 && cols > 0, "矩阵维度必须为正数");
        Matrix { data: vec![fill; rows * cols], rows, cols }
    }

    /// 全零矩阵。
    fn zeros(rows: usize, cols: usize) -> Self {
        Matrix::new(rows, cols, 0.0)
    }

    /// 用一维向量按行优先构造矩阵,长度必须恰好为 rows * cols。
    fn from_vec(data: Vec<f64>, rows: usize, cols: usize) -> Self {
        assert_eq!(
            data.len(),
            rows * cols,
            "数据长度 {} 与矩阵形状 {}×{} 不一致",
            data.len(),
            rows,
            cols
        );
        Matrix { data, rows, cols }
    }

    /// 返回形状 (rows, cols)。
    fn shape(&self) -> (usize, usize) {
        (self.rows, self.cols)
    }

    /// 读取第 i 行第 j 列的元素。
    fn get(&self, i: usize, j: usize) -> f64 {
        assert!(
            i < self.rows && j < self.cols,
            "索引 ({}, {}) 超出矩阵形状 {}×{}",
            i,
            j,
            self.rows,
            self.cols
        );
        self.data[i * self.cols + j]
    }

    /// 写入第 i 行第 j 列的元素。
    fn set(&mut self, i: usize, j: usize, v: f64) {
        assert!(
            i < self.rows && j < self.cols,
            "索引 ({}, {}) 超出矩阵形状 {}×{}",
            i,
            j,
            self.rows,
            self.cols
        );
        self.data[i * self.cols + j] = v;
    }

    /// 取出第 j 列的副本:新建一个 Vec,不影响原矩阵。
    fn col(&self, j: usize) -> Vec<f64> {
        assert!(j < self.cols, "列号 {} 超出矩阵列数 {}", j, self.cols);
        (0..self.rows).map(|i| self.get(i, j)).collect()
    }
}
实现要点:
get/set里的下标正是前面的公式 ;这两个方法是以后所有矩阵运算的”最后一公里”。#[derive(Debug, Clone, PartialEq)]让我们可以{:?}打印整个矩阵、.clone()深拷贝、==比较,测试和调试都靠它。- 构造函数里的
assert!/assert_eq!是运行时检查:一旦违反约定,立即带着清晰信息 panic,而不是悄悄算出错误结果。 - 字段全部私有(没有
pub),外界只能走方法访问,保证”数据长度与形状始终一致”这个不变量不被外部破坏。 - 注意方法签名里的
&self与&mut self:只读的get/shape/col借用不可变引用,会改数据的set借用可变引用——这是本篇「Rust 语法角」的主角。
第二段:xorshift 伪随机数生成器
造数据需要随机数,但标准库没有内置 RNG(外部 crate 一律不用),所以手写一个经典的 xorshift64,十几行,种子固定则结果完全可复现:
// src/main.rs(第二段:xorshift 伪随机数生成器)
/// xorshift64:无需外部依赖,种子固定则结果完全可复现。
struct XorShift(u64);

impl XorShift {
    fn new(seed: u64) -> Self {
        assert!(seed != 0, "种子不能为 0");
        XorShift(seed)
    }

    fn next_u64(&mut self) -> u64 {
        let mut x = self.0;
        x ^= x << 13;
        x ^= x >> 7;
        x ^= x << 17;
        self.0 = x;
        x
    }

    /// 返回 [0, 1) 区间的 f64。
    fn next_f64(&mut self) -> f64 {
        (self.next_u64() >> 11) as f64 / (1u64 << 53) as f64
    }
}
实现要点:
x ^= x << k是”按位异或+移位”,三步搅乱种子比特;数学上保证周期极长,对我们造模拟数据绰绰有余。- 每次调用都要改内部状态,所以是
&mut self;返回值[0, 1)再线性变换到任意区间(如 )。 - 种子固定(本篇用 42)意味着每次
cargo run的数字一字不差——可复现是机器学习实验的基本功,之后每篇造数据都这样做。
第三段:迷你 SVG 绘图器
为了把数据”看见”,系列共用的迷你 SVG 绘图器内联在这里:只做三件事——散点、折线、坐标轴(含网格与刻度),约 130 行,零依赖直接写文件。这是它唯一一次逐行亮相,之后每篇文章原样内联、不再展开。
// src/main.rs(第三段:迷你 SVG 绘图器,系列共用)
use std::fmt::Write as _;
use std::f64::consts::PI;

/// 一张图:坐标映射 + 已累积的 SVG 元素。
struct Canvas {
    w: f64,
    h: f64,
    xmin: f64,
    xmax: f64,
    ymin: f64,
    ymax: f64,
    pad_l: f64,
    pad_r: f64,
    pad_t: f64,
    pad_b: f64,
    body: String,
}

impl Canvas {
    /// 按数据范围自动留 5% 边距建图;xmin == xmax 时手动摊开避免除零。
    fn new(w: f64, h: f64, xmin: f64, xmax: f64, ymin: f64, ymax: f64) -> Canvas {
        let (xmin, xmax) = spread(xmin, xmax);
        let (ymin, ymax) = spread(ymin, ymax);
        Canvas {
            w,
            h,
            xmin,
            xmax,
            ymin,
            ymax,
            pad_l: 52.0,
            pad_r: 16.0,
            pad_t: 16.0,
            pad_b: 40.0,
            body: String::new(),
        }
    }

    fn px(&self, x: f64) -> f64 {
        self.pad_l + (x - self.xmin) / (self.xmax - self.xmin) * (self.w - self.pad_l - self.pad_r)
    }

    fn py(&self, y: f64) -> f64 {
        self.h - self.pad_b - (y - self.ymin) / (self.ymax - self.ymin) * (self.h - self.pad_t - self.pad_b)
    }

    /// 折线,点需按 x 升序传入。
    fn polyline(&mut self, pts: &[(f64, f64)], color: &str, width: f64) {
        let mut d = String::new();
        for (i, (x, y)) in pts.iter().enumerate() {
            let _ = write!(d, "{}{:.1},{:.1}", if i == 0 { "M" } else { "L" }, self.px(*x), self.py(*y));
        }
        let _ = write!(
            self.body,
            r##"<path d="{d}" fill="none" stroke="{color}" stroke-width="{width}" stroke-linejoin="round"/>"##
        );
    }

    /// 散点。
    fn dots(&mut self, pts: &[(f64, f64)], color: &str, r: f64) {
        for (x, y) in pts {
            let _ = write!(
                self.body,
                r##"<circle cx="{:.1}" cy="{:.1}" r="{r}" fill="{color}" fill-opacity="0.65"/>"##,
                self.px(*x),
                self.py(*y)
            );
        }
    }

    /// 坐标轴 + 虚线网格 + 刻度标签。
    fn axes(&mut self, xlabel: &str, ylabel: &str) {
        let x0 = self.px(self.xmin);
        let x1 = self.px(self.xmax);
        let y0 = self.py(self.ymin);
        let y1 = self.py(self.ymax);
        for t in nice_ticks(self.xmin, self.xmax, 6) {
            let x = self.px(t);
            let _ = write!(
                self.body,
                r##"<line x1="{x:.1}" y1="{y0:.1}" x2="{x:.1}" y2="{y1:.1}" stroke="#16161d" stroke-opacity="0.08"/>"##
            );
            let _ = write!(
                self.body,
                r##"<text x="{x:.1}" y="{:.1}" text-anchor="middle" fill="#16161d" fill-opacity="0.45">{t:.6}</text>"##,
                y0 + 16.0,
                t = trim(t)
            );
        }
        for t in nice_ticks(self.ymin, self.ymax, 6) {
            let y = self.py(t);
            let _ = write!(
                self.body,
                r##"<line x1="{x0:.1}" y1="{y:.1}" x2="{x1:.1}" y2="{y:.1}" stroke="#16161d" stroke-opacity="0.08"/>"##
            );
            let _ = write!(
                self.body,
                r##"<text x="{:.1}" y="{:.1}" text-anchor="end" fill="#16161d" fill-opacity="0.45">{t:.6}</text>"##,
                x0 - 6.0,
                y + 4.0,
                t = trim(t)
            );
        }
        let _ = write!(
            self.body,
            r##"<path d="M{x0:.1},{y0:.1}H{x1:.1}M{x0:.1},{y0:.1}V{y1:.1}" fill="none" stroke="#16161d" stroke-opacity="0.6"/>"##
        );
        let _ = write!(
            self.body,
            r##"<text x="{:.1}" y="{:.1}" text-anchor="middle" fill="#16161d" fill-opacity="0.7">{xlabel}</text>"##,
            (x0 + x1) / 2.0,
            self.h - 8.0
        );
        let _ = write!(
            self.body,
            r##"<text x="14" y="{:.1}" text-anchor="middle" transform="rotate(-90 14 {:.1})" fill="#16161d" fill-opacity="0.7">{ylabel}</text>"##,
            (y0 + y1) / 2.0,
            (y0 + y1) / 2.0
        );
    }

    fn save(&self, path: &str) {
        let svg = format!(
            r##"<svg xmlns="http://www.w3.org/2000/svg" viewBox="0 0 {w} {h}" font-family="'JetBrains Mono',monospace" font-size="11"><rect width="{w}" height="{h}" fill="#fbfaf7"/>{body}</svg>"##,
            w = self.w,
            h = self.h,
            body = self.body
        );
        std::fs::write(path, svg).expect("写 SVG 失败");
    }
}

/// 把 fmt 出来的 f64 末尾零去掉,让刻度标签短一点。
fn trim(v: f64) -> String {
    let s = format!("{v:.6}");
    s.trim_end_matches('0').trim_end_matches('.').to_string()
}

/// 数据范围退化成一点时向两侧摊开。
fn spread(min: f64, max: f64) -> (f64, f64) {
    if min == max {
        (min - 1.0, max + 1.0)
    } else {
        let pad = (max - min) * 0.05;
        (min - pad, max + pad)
    }
}

/// “好看”的刻度:步长取 1/2/2.5/5 × 10^k。
fn nice_ticks(min: f64, max: f64, n: usize) -> Vec<f64> {
    let raw = (max - min) / n.max(1) as f64;
    if raw <= 0.0 || !raw.is_finite() {
        return vec![min];
    }
    let exp = raw.abs().log10().floor() as i32;
    let base = 10f64.powi(exp);
    let frac = raw / base;
    let step = if frac <= 1.0 {
        base
    } else if frac <= 2.0 {
        2.0 * base
    } else if frac <= 2.5 {
        2.5 * base
    } else if frac <= 5.0 {
        5.0 * base
    } else {
        10.0 * base
    };
    let mut ticks = Vec::new();
    let mut t = (min / step).ceil() * step;
    while t <= max + 1e-9 {
        ticks.push(if t.abs() < step * 1e-9 { 0.0 } else { t });
        t += step;
    }
    ticks
}
实现要点:
- 核心只有两个映射:
px/py把数据坐标换算成 SVG 像素坐标(y 轴翻转,因为 SVG 的 y 向下)。所有图形元素都只是把这换算后的数字写进字符串。 r##"..."##是原始字符串:里面的"和\都不需要转义,适合内嵌 HTML/SVG 模板;##是定界符,模板里出现"#时才需要换成###。write!(self.body, ...)往字符串里追加内容返回Result,这里用let _ =明确忽略——对String写入不会失败,但 Rust 要求你必须表态。- 刻度用”好看步长”(1/2/2.5/5×10 的幂),坐标范围自动留 5% 边距,图像素尺寸固定 560×400——够用、好读、零依赖。
第四段:单元测试
测试和业务代码同文件:#[cfg(test)] 表示只在跑 cargo test 时编译这段,测试就是带 #[test] 注解的普通函数。
// src/main.rs(第四段:单元测试)
#[cfg(test)]
mod tests {
    use super::*;

    #[test]
    fn zeros_has_right_shape() {
        let m = Matrix::zeros(2, 3);
        assert_eq!(m.shape(), (2, 3));
        assert_eq!(m.get(1, 2), 0.0);
    }

    #[test]
    fn from_vec_is_row_major() {
        // [[1, 2, 3], [4, 5, 6]]
        let m = Matrix::from_vec(vec![1.0, 2.0, 3.0, 4.0, 5.0, 6.0], 2, 3);
        assert_eq!(m.get(0, 1), 2.0); // 第 0 行第 1 列
        assert_eq!(m.get(1, 0), 4.0); // 第 1 行第 0 列
    }

    #[test]
    fn set_and_col_roundtrip() {
        let mut m = Matrix::zeros(2, 2);
        m.set(1, 0, 7.5);
        assert_eq!(m.get(1, 0), 7.5);
        assert_eq!(m.col(0), vec![0.0, 7.5]); // col 返回副本,不影响原矩阵
    }

    #[test]
    #[should_panic(expected = "不一致")]
    fn from_vec_rejects_bad_length() {
        let _ = Matrix::from_vec(vec![1.0, 2.0, 3.0], 2, 2);
    }
}
实现要点:
from_vec_is_row_major用一组具体数字钉死行优先语义:下标 1 对应矩阵第 1 行第 0 列——布局公式 的行为级验证。set_and_col_roundtrip顺带验证col()的”副本”语义:取出来改它,原矩阵不动(这正是语法角要展开的所有权议题)。- 最后一个测试用了
#[should_panic(expected = "不一致")]:它断言这段代码必须恐慌,且 panic 消息里要含”不一致”。数据长度与形状不匹配时就该失败——测试”防御性行为本身”是 fail-fast 代码的标配测试。
第五段:主程序
把前面的零件组装起来:造数据、算统计量、画图。
// src/main.rs(第五段:主程序)
fn main() {
    // ---- 1. 造数据:y = sin(x) + ε,存入 n×2 的 Matrix(第 0 列 x,第 1 列 y) ----
    let mut rng = XorShift::new(42);
    let n = 120usize;
    let mut data = Matrix::zeros(n, 2);
    for i in 0..n {
        let x = rng.next_f64() * 2.0 * PI - PI; // x ∈ [-π, π)
        let eps = (rng.next_f64() - 0.5) * 0.6; // 噪声 ε ∈ [-0.3, 0.3)
        data.set(i, 0, x);
        data.set(i, 1, x.sin() + eps);
    }

    // ---- 2. 打印形状与前 5 个样本,并统计 y 的均值与样本标准差 ----
    println!("data.shape = {:?}(第 0 列是 x,第 1 列是 y)", data.shape());
    println!("前 5 个样本 (x, y):");
    for i in 0..5 {
        println!("  ({:>8.4}, {:>8.4})", data.get(i, 0), data.get(i, 1));
    }
    let ys = data.col(1);
    let mean = ys.iter().sum::<f64>() / n as f64;
    let std = (ys.iter().map(|y| (y - mean).powi(2)).sum::<f64>() / (n - 1) as f64).sqrt();
    println!("y 的样本均值 = {mean:.4},样本标准差 = {std:.4}");

    // ---- 3. 画散点图:红点是带噪声的观测,绿线是干净的真值 sin(x) ----
    let pts: Vec<(f64, f64)> = (0..n).map(|i| (data.get(i, 0), data.get(i, 1))).collect();
    // 真值曲线按行优先摊平成 [x0, y0, x1, y1, ...],再打包成 201×2 矩阵
    let flat: Vec<f64> = (0..=200)
        .flat_map(|k| {
            let x = -PI + k as f64 * 2.0 * PI / 200.0;
            [x, x.sin()]
        })
        .collect();
    let curve = Matrix::from_vec(flat, 201, 2);
    let curve_pts: Vec<(f64, f64)> = (0..=200).map(|k| (curve.get(k, 0), curve.get(k, 1))).collect();

    let dir = "../../../frontend/public/images/series/rust-ml-01-intro";
    std::fs::create_dir_all(dir).expect("创建输出目录失败");
    let mut c = Canvas::new(560.0, 400.0, -PI, PI, -1.4, 1.4);
    c.axes("x", "y");
    c.dots(&pts, "#d6491f", 3.0);
    c.polyline(&curve_pts, "#0f766e", 2.0);
    c.save(&format!("{dir}/scatter.svg"));
    println!("散点图已写入 {dir}/scatter.svg(共 {n} 个样本点)");
}
实现要点:
- 数据集就是”一行一个样本”:第 行是 两个特征——这正是后文所有算法的输入形态。
- 均值、标准差两个累加式直接对照本节开头的公式;
ys.iter().sum::<f64>()是迭代器风格的”对这个 Vec 的所有元素求和”。 - 真值曲线故意用
from_vec打包:把[x0, y0, x1, y1, ...]按行优先还原成 矩阵再逐点取出,等于把第一段的数据布局公式亲手用了一遍。 - 输出目录相对仓库根定位(从工程目录
cargo run时../../即仓库根),create_dir_all自动建多级目录,SVG 直接写进博客静态资源目录,正文用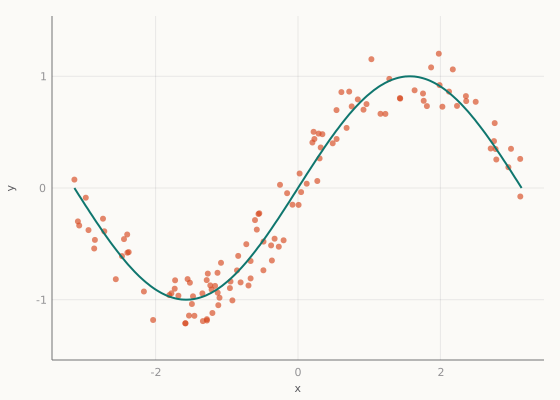引用。
Rust 语法角:所有权与移动
Python 程序员最容易踩的坑,就是 Rust 的赋值语义。Python 里:
a = [[1.0, 2.0], [3.0, 4.0]]
b = a          # b 只是对象的新名字,背后还是同一个列表
b[0][0] = 9.0
print(a[0][0]) # 9.0 —— a 跟着变了
Rust 里同样的写法语义完全不同:
let a = Matrix::from_vec(vec![1.0, 2.0, 3.0, 4.0], 2, 2);
let b = a;              // 不是新名字,而是把 a 的值“移动”进 b
// println!("{:?}", a); // 编译错误:borrow of moved value: `a`
let c = b.clone();      // 想要两个独立副本?显式深拷贝
赋值即移动,移动后旧变量作废——这是 Rust 默认规则,背后是明确的设计动机:矩阵动辄上万元素,默认深拷贝会让性能 silently 崩盘(Python 的 a.copy()/np.copy 是显式的,Rust 也一样,只是更显式)。如果只需要临时看看数据,不要拷贝,用借用:
fn print_shape(m: &Matrix) {          // & 借用:只读,不拿走
    println!("{:?}", m.shape());
}
print_shape(&data);                    // data 之后照常可用
let y = data.col(1);                   // col(&self) -> Vec:返回值是新建的所有权值
data 仍然拥有那个矩阵,print_shape 只是”借去看一眼”;col 则新建一个 Vec 交给你——谁拿到值谁就负责它的释放,编译器在编译期静态检查这套规则,运行期零开销。这套”每个值有且只有一个主人”的纪律,正是理解算法数据流的捷径:当你写 let ys = data.col(1) 时,你清楚地知道接下来改 ys 不会影响 data。
更多细节见《Rust 程序设计语言》第 4 章:Understanding Ownership。
运行结果
cargo test -- --test-threads=1(串行执行,让四行测试的输出顺序稳定;不加该参数时四行的先后顺序可能不同,结果一样):
running 4 tests
test tests::from_vec_is_row_major ... ok
test tests::from_vec_rejects_bad_length - should panic ... ok
test tests::set_and_col_roundtrip ... ok
test tests::zeros_has_right_shape ... ok

test result: ok. 4 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
cargo run:
data.shape = (120, 2)(第 0 列是 x,第 1 列是 y)
前 5 个样本 (x, y):
  ( -3.1416,   0.0751)
  (  0.2718,   0.0628)
  ( -1.2132,  -0.9084)
  (  0.7550,   0.7309)
  (  0.9207,   0.7011)
y 的样本均值 = -0.1556,样本标准差 = 0.7159
散点图已写入 ../../../frontend/public/images/series/rust-ml-01-intro/scatter.svg(共 120 个样本点)
生成的散点图(红点 = 带噪声观测,绿线 = 真值 ):

怎么读这张图和这组数字
- 红点绕着绿线上下波动:波动的幅度就是噪声 的视觉化——所有红点与绿线的纵向距离都在 以内。这张图就是机器学习任务的缩影:规律(绿线)埋在带噪观测(红点)之下,算法要做的事就是从红点的分布里”看出”绿线。
- 第一行样本 ,而 ,所以 几乎全是噪声——离绿线近不等于没噪声,读数据时要看”趋势”而非单点。
- 均值 接近理论值 : 在 上正负对称,理论均值为 0; 的偏差就是抽 120 个样本的抽样误差,样本再多(比如 12000 个)它会继续向 0 收缩。
- 标准差 接近理论值 :方差由”信号的 + 噪声的 “两部分组成,程序只”看到”带噪数据却测出了接近理论的波动水平——这说明数据模型 被忠实搬进了代码。
Rust vs Python 学习路径建议
基础篇不写”算法优缺点”,更适合回答一个实际问题:这一路该用 Rust 还是回到 Python?
- 跟着本系列学原理的阶段,留在 Rust。 亲手实现逼你想清楚每个数据的形状、每一次拷贝与借用;编译器的挑剔会在前期拖慢你,在后期替你挡掉整类 bug。这是打地基的最佳训练场。
- 这些时刻回到 Python 生态:要处理真实世界的数据集(pandas / polars / NumPy 的 IO 与清洗)、要快速画图对比(matplotlib / plotly)、要用深度学习框架(PyTorch / JAX)、要复现论文或对齐社区实现(scikit-learn)。探索的快感 Python 暂时无人能替。
- 互补而非二选一:把本系列写出的每个算法,对照 scikit-learn 或 NumPy 的实现跑一遍同样的数据,看结果是否吻合——这是最好的验收方式。Rust 的 ML 生态(ndarray、burn、candle、polars)正在快速成长,你在本系列练出的功底将来完全能迁移过去。
一句话:探索用 Python,造轮子学原理用 Rust,上生产看性能与可靠性用 Rust。
小结与下篇预告
本篇备好了整个系列的地基:开发环境、单文件体例、核心数据结构 Matrix(能存取、有测试、fail fast),以及两件趁手工具——可复现的 xorshift 随机数、零依赖 SVG 绘图器。我们用它造出了第一批”带噪声的正弦数据”,并画出了系列的第一张图。
Matrix 现在还只能”存放”数据,不能”运算”——基础篇(下)给它装上发动机:点积、矩阵乘法、转置与单位矩阵。写完那一篇,“对整个数据集做一次预测”就只需要一行矩阵乘法。