用 Rust 从头实现机器学习算法·基础篇(下):线性代数运算
用 Rust 从头实现机器学习算法·基础篇(下):线性代数运算
上一篇(基础篇·上)我们搭好了能存放数据的 Matrix,但它还不会运算。本篇给它装上发动机:向量点积、矩阵乘法、转置与单位矩阵——机器学习最重要的四件线性代数工具。数学只需要高中水平:你会求和,就能看懂全部内容。
核心思想
这个系列的方法论是一句话:每个算法都拆成”数学推导 → 可运行代码”两步,而线性代数是几乎所有推导的母语。系列清单在附录里把话挑明了:“线性代数是底座:EVD / SVD(PCA)、投影与正交性(OLS)、二次型与正定性(SVM 对偶)、协方差矩阵(GDA、GPR)——《矩阵力量》贯穿全部章节。”
但底座不是一天建成的。本篇只打磨四件最基本的运算:向量点积、矩阵乘法、转置与单位矩阵。它们加起来不过几十行代码,却足以让”对整个数据集做一次预测”变成一行表达式——这是下一篇线性回归的全部地基。
数学推导
向量与点积
向量就是一串数,记作 。两个长度相同的向量可以做点积:
即”对应位置相乘,再全部加起来”。例如 。
这个看似普通的运算正是线性模型的雏形:把每个特征乘上对应的权重再求和,就是预测值 。整个监督学习,本质上就是在找一组合适的权重。
矩阵乘法:定义与形状规则
矩阵乘法按”行乘列”定义。若 是 矩阵、 是 矩阵,则乘积 是 矩阵,其元素为:
读法: 的第 行第 列,等于 的第 行与 的第 列做点积——矩阵乘法不过是点积的”批量版”。
由此得到最重要的形状规则: 的列数必须等于 的行数(两个内维相等),结果形状由外维决定:。
看个具体例子, 为 、 为 :
验算右下角元素:。
形状规则值得反复强调,因为它是机器学习中最常见的事故来源。在动态类型语言里,形状错误要等运行到那一行才抛异常;我们的实现在入口处用断言把关,让错误在第一时间、带着完整的形状信息暴露出来。
转置与单位矩阵
转置把矩阵沿主对角线翻转: 的第 行第 列等于 的第 行第 列,
形状上, 的矩阵转置后变成 。
单位矩阵 是 方阵:主对角线全是 ,其余全是 。它之于矩阵乘法相当于数字 之于普通乘法——任何矩阵乘单位矩阵都等于自己:
这两件工具无处不在:转置用于在”行样本”与”列样本”之间切换视角,单位矩阵则是理解后续许多推导(例如正规方程)的钥匙。
换个视角:矩阵乘法是对空间的线性变换
以上把矩阵乘法看作”点积的批量版”,代数上够用。但矩阵乘法的另一个身份更值得记住:它是对整个空间的一次线性变换。
拿一个具体的 矩阵:
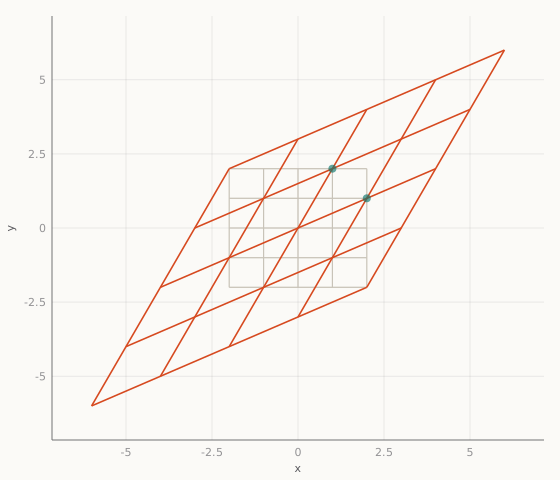
它乘以任意向量 ,得到 ——平面上每个点都被搬到了新位置。把 、 的整数网格线整体搬过去,得到的就是下面「运行结果」里的那张图:淡色网格是变换前,朱橙网格是变换后。
这张图有两个值得停下来的观察:
- 列即基向量的像。、 是两个坐标轴方向的单位向量,而 、——恰好是 的第一列和第二列。矩阵的列告诉我们”基向量去了哪里”;其余所有点都是基的线性组合,自然跟着被拉过去。记住这个结论:矩阵的列就是基的像。
- 直线仍然是直线。原来横平竖直的网格,变换后依旧横竖分明、保持平行。这不是 运气好,而是”线性”二字的含义(保加法、保数乘)——线性变换必然把直线映成直线。画网格图的价值正在于此:让”矩阵乘法 = 对空间的线性变换”变成肉眼可检查的事实。
Rust 实现
思路齐了,写代码。本篇延续”单文件可复现”的约定:Matrix 的结构和方法与上一篇一致(仅去掉 pub,单文件程序无需对外可见),四件运算、绘图器、可视化与测试全部写进同一个 main.rs,零外部依赖,cargo run 即可运行。
// src/main.rs
// 用 Rust 从头实现机器学习算法·基础篇(下):线性代数运算
// 单文件完整实现:Matrix 四件运算(点积 / 矩阵乘法 / 转置 / 单位矩阵)
// + 迷你 SVG 绘图器 + 2D 线性变换可视化。仅依赖标准库。

use std::fmt::Write as _;

// ---------- Matrix:行优先存储的二维浮点矩阵 ----------

#[derive(Debug, Clone, PartialEq)]
struct Matrix {
    data: Vec<f64>, // 第 i 行第 j 列的元素存放在 data[i * cols + j]
    rows: usize,
    cols: usize,
}

impl Matrix {
    /// 构造一个所有元素都等于 fill 的 rows×cols 矩阵。
    fn new(rows: usize, cols: usize, fill: f64) -> Self {
        assert!(rows > 0 && cols > 0, "矩阵维度必须为正数");
        Matrix { data: vec![fill; rows * cols], rows, cols }
    }

    /// 全零矩阵。
    fn zeros(rows: usize, cols: usize) -> Self {
        Matrix::new(rows, cols, 0.0)
    }

    /// 用一维向量按行优先构造矩阵,长度必须恰好为 rows * cols。
    fn from_vec(data: Vec<f64>, rows: usize, cols: usize) -> Self {
        assert_eq!(
            data.len(),
            rows * cols,
            "数据长度 {} 与矩阵形状 {}×{} 不一致",
            data.len(),
            rows,
            cols
        );
        Matrix { data, rows, cols }
    }

    /// 返回形状 (rows, cols)。
    fn shape(&self) -> (usize, usize) {
        (self.rows, self.cols)
    }

    /// 读取第 i 行第 j 列的元素。
    fn get(&self, i: usize, j: usize) -> f64 {
        assert!(
            i < self.rows && j < self.cols,
            "索引 ({}, {}) 超出矩阵形状 {}×{}",
            i,
            j,
            self.rows,
            self.cols
        );
        self.data[i * self.cols + j]
    }

    /// 逐元素相加。两个矩阵的形状必须完全一致。
    fn add(&self, other: &Matrix) -> Matrix {
        assert_eq!(
            self.shape(),
            other.shape(),
            "形状不一致:{:?} 与 {:?} 无法相加",
            self.shape(),
            other.shape()
        );
        let data: Vec<f64> = self
            .data
            .iter()
            .zip(other.data.iter())
            .map(|(a, b)| a + b)
            .collect();
        Matrix { data, rows: self.rows, cols: self.cols }
    }

    /// 矩阵乘法:(n×m) · (m×p) → (n×p)。
    fn matmul(&self, other: &Matrix) -> Matrix {
        assert_eq!(
            self.cols, other.rows,
            "内维不一致:{}×{} 无法乘 {}×{}",
            self.rows, self.cols, other.rows, other.cols
        );
        let mut out = Matrix::zeros(self.rows, other.cols);
        for i in 0..self.rows {
            for j in 0..other.cols {
                let mut sum = 0.0;
                for k in 0..self.cols {
                    sum += self.data[i * self.cols + k] * other.data[k * other.cols + j];
                }
                out.data[i * out.cols + j] = sum;
            }
        }
        out
    }

    /// 转置:n×m → m×n。
    fn transpose(&self) -> Matrix {
        let mut out = Matrix::zeros(self.cols, self.rows);
        for i in 0..self.rows {
            for j in 0..self.cols {
                out.data[j * self.rows + i] = self.data[i * self.cols + j];
            }
        }
        out
    }

    /// n×n 单位矩阵:对角线为 1,其余为 0。
    fn identity(n: usize) -> Matrix {
        let mut out = Matrix::zeros(n, n);
        for i in 0..n {
            out.data[i * n + i] = 1.0;
        }
        out
    }
}

/// 向量点积:对应位置相乘再全部加起来,两个向量长度必须一致。
fn dot(a: &[f64], b: &[f64]) -> f64 {
    assert_eq!(
        a.len(),
        b.len(),
        "长度不一致:{} 维向量无法与 {} 维向量做点积",
        a.len(),
        b.len()
    );
    a.iter().zip(b.iter()).map(|(x, y)| x * y).sum()
}

// ---------- 迷你 SVG 绘图器:零依赖(仅 std),把数据写成 SVG 文件 ----------
// 这是系列文章的共享绘图工具,每篇文章的代码中都会内联同一份实现。

/// 一张图:坐标映射 + 已累积的 SVG 元素。
struct Canvas {
    w: f64,
    h: f64,
    xmin: f64,
    xmax: f64,
    ymin: f64,
    ymax: f64,
    pad_l: f64,
    pad_r: f64,
    pad_t: f64,
    pad_b: f64,
    body: String,
}

impl Canvas {
    /// 按数据范围自动留 5% 边距建图;xmin == xmax 时手动摊开避免除零。
    fn new(w: f64, h: f64, xmin: f64, xmax: f64, ymin: f64, ymax: f64) -> Canvas {
        let (xmin, xmax) = spread(xmin, xmax);
        let (ymin, ymax) = spread(ymin, ymax);
        Canvas {
            w,
            h,
            xmin,
            xmax,
            ymin,
            ymax,
            pad_l: 52.0,
            pad_r: 16.0,
            pad_t: 16.0,
            pad_b: 40.0,
            body: String::new(),
        }
    }

    fn px(&self, x: f64) -> f64 {
        self.pad_l + (x - self.xmin) / (self.xmax - self.xmin) * (self.w - self.pad_l - self.pad_r)
    }

    fn py(&self, y: f64) -> f64 {
        self.h - self.pad_b - (y - self.ymin) / (self.ymax - self.ymin) * (self.h - self.pad_t - self.pad_b)
    }

    /// 折线,点需按 x 升序传入。
    fn polyline(&mut self, pts: &[(f64, f64)], color: &str, width: f64) {
        let mut d = String::new();
        for (i, (x, y)) in pts.iter().enumerate() {
            let _ = write!(d, "{}{:.1},{:.1}", if i == 0 { "M" } else { "L" }, self.px(*x), self.py(*y));
        }
        let _ = write!(
            self.body,
            r##"<path d="{d}" fill="none" stroke="{color}" stroke-width="{width}" stroke-linejoin="round"/>"##
        );
    }

    /// 散点。
    fn dots(&mut self, pts: &[(f64, f64)], color: &str, r: f64) {
        for (x, y) in pts {
            let _ = write!(
                self.body,
                r##"<circle cx="{:.1}" cy="{:.1}" r="{r}" fill="{color}" fill-opacity="0.65"/>"##,
                self.px(*x),
                self.py(*y)
            );
        }
    }

    /// 坐标轴 + 虚线网格 + 刻度标签。
    fn axes(&mut self, xlabel: &str, ylabel: &str) {
        let x0 = self.px(self.xmin);
        let x1 = self.px(self.xmax);
        let y0 = self.py(self.ymin);
        let y1 = self.py(self.ymax);
        for t in nice_ticks(self.xmin, self.xmax, 6) {
            let x = self.px(t);
            let _ = write!(
                self.body,
                r##"<line x1="{x:.1}" y1="{y0:.1}" x2="{x:.1}" y2="{y1:.1}" stroke="#16161d" stroke-opacity="0.08"/>"##
            );
            let _ = write!(
                self.body,
                r##"<text x="{x:.1}" y="{:.1}" text-anchor="middle" fill="#16161d" fill-opacity="0.45">{t:.6}</text>"##,
                y0 + 16.0,
                t = trim(t)
            );
        }
        for t in nice_ticks(self.ymin, self.ymax, 6) {
            let y = self.py(t);
            let _ = write!(
                self.body,
                r##"<line x1="{x0:.1}" y1="{y:.1}" x2="{x1:.1}" y2="{y:.1}" stroke="#16161d" stroke-opacity="0.08"/>"##
            );
            let _ = write!(
                self.body,
                r##"<text x="{:.1}" y="{:.1}" text-anchor="end" fill="#16161d" fill-opacity="0.45">{t:.6}</text>"##,
                x0 - 6.0,
                y + 4.0,
                t = trim(t)
            );
        }
        let _ = write!(
            self.body,
            r##"<path d="M{x0:.1},{y0:.1}H{x1:.1}M{x0:.1},{y0:.1}V{y1:.1}" fill="none" stroke="#16161d" stroke-opacity="0.6"/>"##
        );
        let _ = write!(
            self.body,
            r##"<text x="{:.1}" y="{:.1}" text-anchor="middle" fill="#16161d" fill-opacity="0.7">{xlabel}</text>"##,
            (x0 + x1) / 2.0,
            self.h - 8.0
        );
        let _ = write!(
            self.body,
            r##"<text x="14" y="{:.1}" text-anchor="middle" transform="rotate(-90 14 {:.1})" fill="#16161d" fill-opacity="0.7">{ylabel}</text>"##,
            (y0 + y1) / 2.0,
            (y0 + y1) / 2.0
        );
    }

    fn save(&self, path: &str) {
        let svg = format!(
            r##"<svg xmlns="http://www.w3.org/2000/svg" viewBox="0 0 {w} {h}" font-family="'JetBrains Mono',monospace" font-size="11"><rect width="{w}" height="{h}" fill="#fbfaf7"/>{body}</svg>"##,
            w = self.w,
            h = self.h,
            body = self.body
        );
        std::fs::write(path, svg).expect("写 SVG 失败");
    }
}

/// 把 fmt 出来的 f64 末尾零去掉,让刻度标签短一点。
fn trim(v: f64) -> String {
    let s = format!("{v:.6}");
    s.trim_end_matches('0').trim_end_matches('.').to_string()
}

/// 数据范围退化成一点时向两侧摊开。
fn spread(min: f64, max: f64) -> (f64, f64) {
    if min == max {
        (min - 1.0, max + 1.0)
    } else {
        let pad = (max - min) * 0.05;
        (min - pad, max + pad)
    }
}

/// “好看”的刻度:步长取 1/2/2.5/5 × 10^k。
fn nice_ticks(min: f64, max: f64, n: usize) -> Vec<f64> {
    let raw = (max - min) / n.max(1) as f64;
    if raw <= 0.0 || !raw.is_finite() {
        return vec![min];
    }
    let exp = raw.abs().log10().floor() as i32;
    let base = 10f64.powi(exp);
    let frac = raw / base;
    let step = if frac <= 1.0 {
        base
    } else if frac <= 2.0 {
        2.0 * base
    } else if frac <= 2.5 {
        2.5 * base
    } else if frac <= 5.0 {
        5.0 * base
    } else {
        10.0 * base
    };
    let mut ticks = Vec::new();
    let mut t = (min / step).ceil() * step;
    while t <= max + 1e-9 {
        ticks.push(if t.abs() < step * 1e-9 { 0.0 } else { t });
        t += step;
    }
    ticks
}

// ---------- 2D 线性变换可视化 ----------

/// 把 x∈[-2,2]、y∈[-2,2] 的整数网格用 2×2 矩阵 m 做线性变换,
/// 同一张图画出变换前的淡网格与变换后的朱橙网格。
fn plot_grid_transform(m: &Matrix, path: &str) {
    // (x', y') = M · (x, y)
    let at = |x: f64, y: f64| {
        (m.get(0, 0) * x + m.get(0, 1) * y, m.get(1, 0) * x + m.get(1, 1) * y)
    };
    // 变换后坐标范围约 ±6,画布对称留边
    let mut c = Canvas::new(560.0, 480.0, -6.5, 6.5, -6.5, 6.5);
    c.axes("x", "y");
    // 变换前:[-2, 2] 的整数网格线,浅色
    for k in -2..=2 {
        let k = k as f64;
        c.polyline(&[(-2.0, k), (2.0, k)], "#c8c3b8", 1.2); // 横线 y = k
        c.polyline(&[(k, -2.0), (k, 2.0)], "#c8c3b8", 1.2); // 竖线 x = k
    }
    // 变换后:每条网格线的两个端点先乘 m,朱橙。
    // 只需算端点——线性变换把直线映成直线。
    for k in -2..=2 {
        let k = k as f64;
        c.polyline(&[at(-2.0, k), at(2.0, k)], "#d6491f", 1.6);
        c.polyline(&[at(k, -2.0), at(k, 2.0)], "#d6491f", 1.6);
    }
    // 基向量的像:M·e1 与 M·e2,即 M 的两列
    c.dots(&[at(1.0, 0.0), at(0.0, 1.0)], "#0f766e", 4.0);
    c.save(path);
}

// ---------- 入口:跑一遍四件运算,生成线性变换图 ----------

fn main() {
    // [[1, 2, 3], [4, 5, 6]] · [[7, 8], [9, 10], [11, 12]]
    let a = Matrix::from_vec(vec![1.0, 2.0, 3.0, 4.0, 5.0, 6.0], 2, 3);
    let b = Matrix::from_vec(vec![7.0, 8.0, 9.0, 10.0, 11.0, 12.0], 3, 2);
    let c = a.matmul(&b); // 2×3 · 3×2 = 2×2
    println!("A·B = {:?}", c);
    println!("(1,2,3)·(4,5,6) = {}", dot(&[1.0, 2.0, 3.0], &[4.0, 5.0, 6.0]));
    println!("A + A = {:?}", a.add(&a));
    println!("A^T = {:?}", a.transpose()); // 3×2
    println!("A·I3 = {:?}", a.matmul(&Matrix::identity(3))); // 应等于 A

    // 线性变换 M = [[2, 1], [1, 2]]:两列分别是基向量 e1、e2 的像
    let m = Matrix::from_vec(vec![2.0, 1.0, 1.0, 2.0], 2, 2);
    let e1 = Matrix::from_vec(vec![1.0, 0.0], 2, 1);
    let e2 = Matrix::from_vec(vec![0.0, 1.0], 2, 1);
    println!("M·e1 = {:?}", m.matmul(&e1)); // M 的第一列
    println!("M·e2 = {:?}", m.matmul(&e2)); // M 的第二列

    // 图片写入站点静态目录:frontend/public/images/series/<slug>/
    // cargo run 的工作目录是 crate 根(series/rust-ml-02-linear-algebra/),
    // 向上一层是 series/,再向上一层是仓库根,然后进入 frontend/。
    let out_dir = "../../../frontend/public/images/series/rust-ml-02-linear-algebra";
    std::fs::create_dir_all(out_dir).expect("创建图片目录失败");
    let path = format!("{out_dir}/grid-transform.svg");
    plot_grid_transform(&m, &path);
    println!("SVG 已生成: {path}");
}

// ---------- 单元测试 ----------

#[cfg(test)]
mod tests {
    use super::*;

    // [[1, 2, 3], [4, 5, 6]],2×3
    fn sample() -> Matrix {
        Matrix::from_vec(vec![1.0, 2.0, 3.0, 4.0, 5.0, 6.0], 2, 3)
    }

    #[test]
    fn dot_multiplies_then_sums() {
        assert_eq!(dot(&[1.0, 2.0, 3.0], &[4.0, 5.0, 6.0]), 32.0);
    }

    #[test]
    #[should_panic(expected = "长度不一致")]
    fn dot_rejects_mismatch() {
        let _ = dot(&[1.0, 2.0], &[1.0, 2.0, 3.0]);
    }

    #[test]
    fn add_is_elementwise() {
        let m = sample().add(&sample());
        assert_eq!(m.shape(), (2, 3));
        assert_eq!(m.get(0, 1), 4.0);
        assert_eq!(m.get(1, 2), 12.0);
    }

    #[test]
    #[should_panic(expected = "形状不一致")]
    fn add_rejects_mismatch() {
        let _ = sample().add(&Matrix::zeros(3, 2));
    }

    #[test]
    fn matmul_computes_dot_products() {
        let b = Matrix::from_vec(vec![7.0, 8.0, 9.0, 10.0, 11.0, 12.0], 3, 2);
        let c = sample().matmul(&b); // 2×3 · 3×2 = 2×2
        assert_eq!(c.shape(), (2, 2));
        assert_eq!(c.get(0, 0), 58.0); // 1×7 + 2×9 + 3×11
        assert_eq!(c.get(1, 1), 154.0); // 4×8 + 5×10 + 6×12
    }

    #[test]
    #[should_panic(expected = "内维不一致")]
    fn matmul_rejects_incompatible_shapes() {
        let _ = sample().matmul(&sample()); // 2×3 乘 2×3,内维 3 ≠ 2
    }

    #[test]
    fn transpose_swaps_rows_and_cols() {
        let t = sample().transpose(); // 3×2
        assert_eq!(t.shape(), (3, 2));
        assert_eq!(t.get(0, 1), 4.0);
        assert_eq!(t.get(2, 0), 3.0);
    }

    #[test]
    fn identity_is_neutral() {
        let c = sample().matmul(&Matrix::identity(3)); // 2×3 · 3×3
        assert_eq!(c, sample());
    }
}
实现要点,按代码中的四段分别说明:
Matrix结构:行优先存储(data[i * cols + j]),单块连续内存,缓存友好;字段私有、构造时断言,“数据长度与形状一致”这个不变量由类型自己守护。- 四件运算:
dot用zip+sum直译”对应相乘再相加”;matmul的三重循环逐字翻译 ,入口断言内维相等;transpose注意写入位置是out.data[j * self.rows + i],行列索引互换;identity从全零矩阵出发只填对角线。 - 绘图器:系列各篇共享的迷你 SVG 绘图器(散点 / 折线 / 坐标轴),与本系列其他文章内联的是同一份实现,零依赖,读者单文件即可复现。
plot_grid_transform:只变换每条网格线的两个端点就动笔——线性变换把直线映成直线,中间点必然落在两端点连线的像上。淡网格(#c8c3b8)与朱橙网格(#d6491f)画进同一张图,绿点标出基向量的像。- 测试:8 个用例,其中 3 个用
#[should_panic]断言”形状 / 长度错误必须 panic”——防御行为本身也是被测试的对象。
Rust 语法角:impl、&self 与同模块私有字段
从 Python 过来的读者,这段代码里有三件事值得停下来看。更多细节见《Rust 程序设计语言》第 5 章”方法语法”(Method Syntax)。
第一,方法写在 impl 块里,接收者用 &self 显式声明。 Python 里方法本质是一个以 self 为首参数的普通函数,调用时 self 隐式传入(a.matmul(b) 背后是 Matrix.matmul(a, b))。Rust 把函数与类型的绑定关系提到语法层面:方法必须写在 impl Matrix 块内,第一个参数声明为 self(搬走自己)、&self(只借用)或 &mut self(可修改的借用),调用时同样不显式传自己——a.matmul(&b)。&self 的含义是”这个方法只读不写”:matmul 不会修改 self 与 other 的任何元素,Rust 在编译期替你担保。
第二,私有是模块级的硬约束,不是命名约定。 Python 的私有靠下划线君子协定:self._data 只是”劝你别碰”,外部 m._data 照改不误。Rust 里 data、rows、cols 没有 pub,模块外的代码连读都读不到,编译直接报错。封装从”自觉”升级成了”编译期强制执行”。
第三,同一模块内,私有字段对彼此透明。 matmul 直接读写了 other.data——other 虽然是另一个实例,但 matmul 与字段定义在同一个模块里,私有边界不挡自己人。所以 Rust 不需要 Java 式的 getData() / setData() 样板代码:该藏的对外藏住,该用的内部直接用。
运行结果
cargo test:8 个用例全部通过,3 个 should_panic 按预期捕获形状错误。
running 8 tests
test tests::add_is_elementwise ... ok
test tests::add_rejects_mismatch - should panic ... ok
test tests::dot_multiplies_then_sums ... ok
test tests::dot_rejects_mismatch - should panic ... ok
test tests::identity_is_neutral ... ok
test tests::matmul_computes_dot_products ... ok
test tests::matmul_rejects_incompatible_shapes - should panic ... ok
test tests::transpose_swaps_rows_and_cols ... ok

test result: ok. 8 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
cargo run:
A·B = Matrix { data: [58.0, 64.0, 139.0, 154.0], rows: 2, cols: 2 }
(1,2,3)·(4,5,6) = 32
A + A = Matrix { data: [2.0, 4.0, 6.0, 8.0, 10.0, 12.0], rows: 2, cols: 3 }
A^T = Matrix { data: [1.0, 4.0, 2.0, 5.0, 3.0, 6.0], rows: 3, cols: 2 }
A·I3 = Matrix { data: [1.0, 2.0, 3.0, 4.0, 5.0, 6.0], rows: 2, cols: 3 }
M·e1 = Matrix { data: [2.0, 1.0], rows: 2, cols: 1 }
M·e2 = Matrix { data: [1.0, 2.0], rows: 2, cols: 1 }
SVG 已生成: ../../../frontend/public/images/series/rust-ml-02-linear-algebra/grid-transform.svg逐行对照:A·B 的两个元素 、,与数学推导一节的手算一致;A·I3 打印结果与 A 完全相同,单位矩阵的中性一目了然;M·e1 = (2, 1)^\top、M·e2 = (1, 2)^\top 正是 的两列——“列即基向量的像”在输出里再次成立。
程序生成的线性变换图:
怎么读这张图
- 从淡网格到朱橙网格:朱橙网格不是重画出来的,是每一条淡网格线的两个端点各乘一次 得到的。横线 变成斜率为 的直线(端点 的像纵坐标相差一半横坐标增量),竖线 同理倾斜——整个平面被均匀地”拧”了一把。
- 绿点就是 的列: 与 是基向量的落点。图中朱橙网格的所有交点,都可以由这两个绿点加权组合出来——这正是”矩阵的列是基的像”的图形版本。
- 直线仍是直线:注意朱橙网格横竖依旧分明、保持平行,没有被掰弯。线性变换不改变”直”与”平行”,只改变倾斜与间距——这张图就是该性质的可视化检验。
- 面积被放大到 3 倍:原来的单位正方形(面积 )被拉成了平行四边形,面积 。这个”面积缩放倍数”就是行列式 ,先混个脸熟——到了降维篇(PCA 与 SVD),它还会以”特征值”的身份重新登场。
什么时候这些运算会成为瓶颈
四件运算里,真正的重量级选手只有一个:矩阵乘法。
- 复杂度是立方级的:
matmul的三重循环是 ,方阵情形下即 。维度翻 10 倍(),运算量翻 1000 倍——朴素实现在小数据下毫秒级,到了真实规模立刻原形毕露。点积 、转置 、单位矩阵构造 相比之下都不算瓶颈;后续算法(OLS 的正规方程、PCA 的协方差矩阵)的性能热点几乎全部集中在矩阵乘法上。 - 朴素实现还不缓存友好:行优先存储下访问 的某一列要按
cols的步长跳,大矩阵时每次访问都是缓存未命中。标准的第一步优化是分块(tiling):把乘积分成能塞进缓存的小块,让数据在寄存器里被复用多次。 - 再往后:循环重排、SIMD 向量化、多线程,直到直接调用工业界调优了几十年的 BLAS / LAPACK——NumPy、PyTorch 的底层同样是它们。本系列刻意保持朴素实现:学习阶段的代码量小、数据量小,清晰优先;而正因为性能热点集中在
matmul一处,将来想把整个系列提速,只需要替换这一个函数。
小结与下篇预告
Matrix 现在既会存也会算了:点积、矩阵乘法、转置、单位矩阵,外加一张图建立的几何直觉——矩阵乘法的列是基的像。把视角抬高一点,就能看到这套工具的真正用途:把 个样本、每个样本 个特征排成数据矩阵 (形状 ),把 个权重排成向量 (形状 ),那么对整个数据集的一次预测就是一次矩阵乘法:
的形状为 ,恰好是 个样本的预测值——一行代码替代成千上万次循环。这就是线性代数值得学的原因。
下一篇进入系列正篇回归①:OLS 线性回归与梯度下降:先用最小二乘定义”拟合得好不好”,再沿梯度反方向一步步改进参数。今天埋下的伏笔会当场兑现—— 不只是演示,它就是训练循环里每轮都要算的那行预测。